
如果你手里还有几张 RTX 2080 Ti,尤其是 22GB 显存版本,可能多少都会有一种感觉:卡还没坏,算力也并不算弱,但到了今天的大模型时代,却越来越容易被软件生态“提前退休”。
问题并不完全出在硬件本身。
RTX 2080 Ti 属于 Turing 架构,计算能力 SM75。现在很多主流大模型推理框架、CUDA Kernel 和量化优化路径,越来越明显地向 Ampere、Ada、Hopper 甚至更新架构倾斜。很多针对新卡设计的高性能算子,放到 SM75 上要么无法使用,要么只能回退到性能并不理想的通用实现。
但我们手里的这批 2080 Ti,单卡拥有 22GB 显存,四卡就是接近 88GB 的物理显存,而且两两之间还有 NVLink。
直接丢掉,实在有点可惜。
于是,这个项目就这么开始了。
【草凡人工智能2080Ti服务器客户可联系原客服/销售免费部署本系统】
一、Caovan SGLang SM75 Accelerator 是什么?
Caovan SGLang SM75 Accelerator,中文可以理解为“草凡 SGLang SM75 推理加速器”。
它不是一个重新发明的大模型推理框架,而是在 SGLang 的基础上,针对 NVIDIA SM75 架构以及 Qwen3.8 系列模型重新做了一轮底层适配、算子优化、推理链优化和运行时增强。
目前主要开发、测试环境是:
- GPU:4 × NVIDIA RTX 2080 Ti 22GB
- GPU 架构:Turing / SM75
- 双卡拓扑:NVLink NV2
- 四卡拓扑:0-1、2-3 两组 NVLink
- 模型:Qwen3.8-27B-AWQ-INT4
- 量化:INT4 / compressed-tensors / pack-quantized
- 上下文:最高 262144 tokens
- 推理框架:SGLang
- 运行模式:TP2 / TP4
- Speculative Decoding:MTP / AutoMTP
简单来说,它真正想解决的是一个很现实的问题:
在不更换现有 RTX 2080 Ti 硬件的前提下,尽可能把这批老卡的大模型推理性能、稳定性和可用性重新拉回一个有实际生产价值的水平。
二、为什么不是“装好 SGLang 就完事”?
最开始我也以为事情会简单很多。
模型能加载、接口能返回、GPU 能跑起来,看起来似乎就结束了。
真正做深入测试以后,才发现远不是这么回事。
在 SM75 上,大模型推理中的问题往往不是某一个地方慢,而是一整条链路里存在很多“小问题”叠加:
- 某些 Humming W4A16 GEMM 在特定 shape 下性能不理想;
- Stream-K 在部分计算形状下会带来非常细微但真实存在的数值非确定性;
- MTP speculative decoding 对 CUDA Graph、draft model、target model 的状态同步要求很高;
- TP2 和 TP4 下,矩阵分片形状完全不同,不能简单共用一个 tuning;
- Qwen3.8 本身又是 hybrid linear attention / GDN / Mamba 风格结构;
- 长输出过程中,EOS、reasoning、speculative sampling 之间还会发生非常隐蔽的交互。
有些问题甚至只有连续生成几万 tokens 之后才会暴露。
所以这个项目后来的开发思路也逐渐变得很明确:
不是简单调几个启动参数,而是从真正的 GPU Kernel、CUDA Graph、MTP、sampling、KV Cache、状态机一路向下做。
三、最直观的变化:2080 Ti 上的推理速度真正跑起来了
很多人看这种产品,最关心的第一件事还是速度。
先说测试结论。
在项目研发阶段,我们针对同一套 4 × RTX 2080 Ti 22GB 环境进行了大量实机测试。
其中比较有代表性的一轮结果如下:
| 运行模式 | 研发实测表现 |
|---|---|
| TP4 + AutoMTP | 长期运行可保持三位数 TPS,峰值达到 140+ TPS |
| TP4 中文复杂任务 | 部分测试平均约 80+ TPS |
| TP2 + AutoMTP | 长期约 110+ TPS,峰值达到 140+ TPS |
| TP2 中文技术类任务 | 部分测试平均约 65+ TPS |
需要特别说明:以上数据来自研发过程中的特定模型、特定硬件、特定提示词及参数环境,实际 TPS 会随着输入长度、输出内容、MTP 接受率、上下文占用、并发数量等因素变化,并不是“任何请求都固定 140 TPS”。
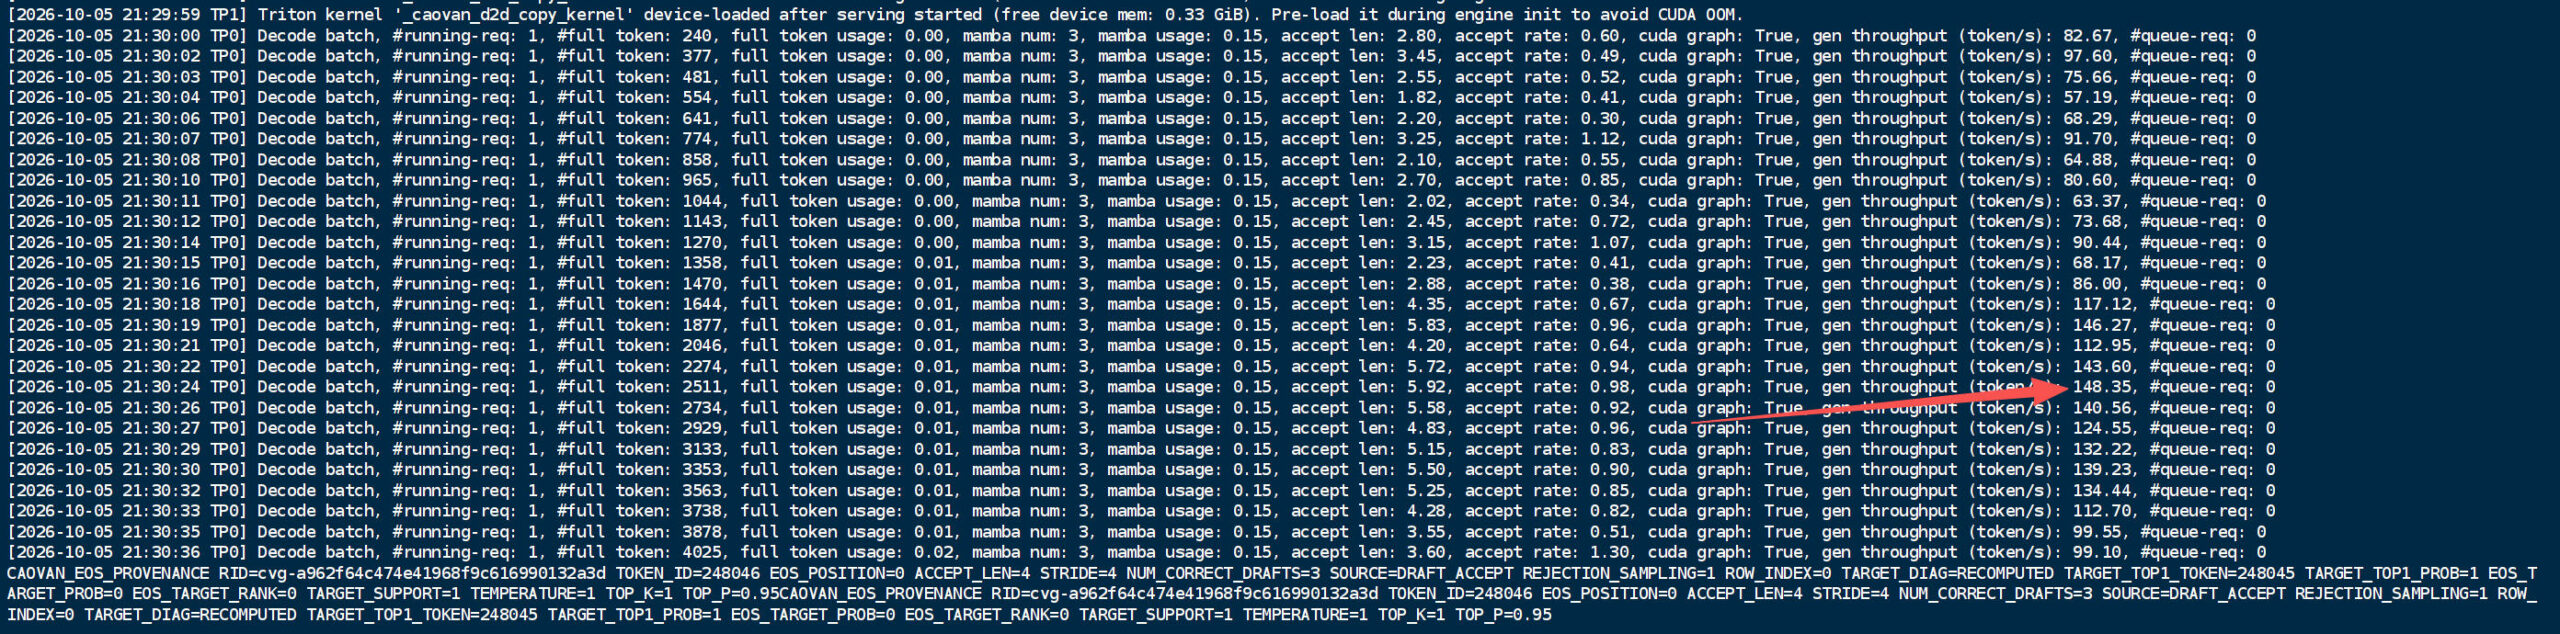
但它至少证明了一件事:
RTX 2080 Ti 远没有到“不能跑现代大模型”的程度,真正缺的是针对 SM75 的软件优化。
四、MTP 不只是“开或关”,还支持 AutoMTP
Qwen3.8 的 MTP speculative decoding 是整个加速链路的重要组成部分。
目前 Caovan SGLang SM75 Accelerator 已经针对 TP2 和 TP4 提供完整的 MTP 组合。
TP2
- MTP OFF
- 固定 MTP3
- 固定 MTP4
- AutoMTP:MTP3 ↔ MTP6 动态切换
TP4
- MTP OFF
- 固定 MTP4
- 固定 MTP5
- AutoMTP:MTP4 ↔ MTP5 动态切换
AutoMTP 的意义并不是单纯把 MTP 数字调得越高越好。
更合理的思路,是根据当前运行状态,在速度、接受率、显存和稳定性之间动态寻找更合适的 speculative width。
最终 GA 前,我们对上述所有用户可选 MTP 模式都做了完整实机覆盖。
五、支持 262144 上下文,并针对并发自动限制可选范围
Qwen3.8-27B 本身支持 262144 context。
但“模型支持 262K”和“任何并发都可以随便开 262K”显然不是一回事。
所以在启动菜单里,上下文长度会和最大并发数联动。
目前的策略大致是:
| 最大并发 | 允许上下文 |
|---|---|
| ≤ 4 | 262144 / 131072 / 65536 / 32768 |
| 5~8 | 131072 / 65536 / 32768 |
| 9~16 | 65536 / 32768 |
这并不是为了“限制用户”,而是为了避免用户随手选择一个看起来很大的参数,最后把所有显存一次性打爆。
六、多卡并发、NVLink 和 CUDA Graph
目前产品同时覆盖:
- TP2 双卡
- TP4 四卡
- NVLink 双卡优化
- 无 NVLink 也可运行
- 最大并发请求数可配置
- Decode CUDA Graph
- target verify CUDA Graph
- draft decode / extend CUDA Graph
在我自己的 4 × 2080 Ti 机器上:
GPU0 ↔ GPU1:NV2
GPU2 ↔ GPU3:NV2
四卡并不是全互联 NVLink,所以 TP4 的通信模型比双卡复杂很多。
也正因为这样,TP2 和 TP4 的算子 tuning、正确性策略并不是简单复制。
七、启动的时候,用户真正需要面对的参数并不复杂
虽然底层做了很多东西,但最终用户并不需要理解 A65、A97、Stream-K 或 speculative sampling。
启动时主要选择:
- 模型
- GPU
- TP2 / TP4
- MTP 模式
- 最大并发
- 上下文长度
- 思考等级
- 通信模式
例如:
caovan-sglang start
即可进入交互式启动菜单。
对于自动化部署,也可以直接通过命令行参数启动。
八、适合哪些人?
这个产品目前最适合下面几类用户。
1. 手里已经有 RTX 2080 Ti 22GB
特别是两张、四张甚至更多卡的用户。
相比直接重新购买几张新 GPU,如果现有服务器还能继续使用,那么先把硬件性能真正挖出来,经济账其实很好算。
2. 想在本地跑 Qwen3.8-27B
尤其是有隐私、本地知识库、代码、Agent、自动化工具调用需求的用户。
3. 已经在使用 SGLang,但 SM75 性能不满意
如果你在新 GPU 上使用 SGLang,很多问题可能根本感受不到。
但在 Turing 上,不少默认路径并不是最优路径。
4. 更在意“长期稳定跑”,而不是只跑一张 benchmark
这个项目后期花在正确性、长输出、并发和异常状态上的时间,其实比最开始做 TPS 加速花得还多。
九、它不是什么?
为了避免产生错误预期,也有必要说清楚。
它不是:
- 把 2080 Ti 变成 RTX 5090;
- 保证任何 prompt 都达到 140 TPS;
- 让任何模型、任何量化格式都自动获得同样加速;
- 绕过显存容量和 PCIe 带宽这些物理限制。
它真正做的,是:
针对一套明确的硬件和模型生态,把原本没有被充分照顾的 SM75 推理路径重新做一遍。
十、目前正式 GA 基线:v1.0.46
截至目前,Caovan SGLang SM75 Accelerator v1.0.46 已经完成 GA 验收。
GA,即 General Availability,可以理解为正式可用、正式发布版本。
v1.0.46 已完成:
- TP2 OFF / MTP3 / MTP4 / AutoMTP 验收;
- TP4 OFF / MTP4 / MTP5 / AutoMTP 验收;
- TP2 A65 correctness;
- TP4 A97 + A64 correctness;
- Generic Completion Guard;
- Speculative Completion Guard;
- CUDA Graph;
- 长输出;
- 多模态;
- 并发请求状态隔离;
- 完整安装、升级与回滚门禁。
这也是后续版本继续研发的稳定基线。
十一、接下来还会继续做什么?
v1.0.46 并不是终点。
后面的方向已经比较明确。
继续提升 TP2 / TP4 TPS
正确性稳定以后,可以重新把重点放回性能:
- draft head;
- MTP accept rate;
- CUDA Graph;
- 更多 SM75 专用 kernel;
- 通信与 NVLink 调优。
KV 虚拟内存
这是我目前很感兴趣的一个方向。
目标不是单纯把 context 数字做大,而是让 GPU 只保存活跃 KV working set,将冷 KV 下沉到主机内存甚至 NVMe。
如果这条路线能够和 SGLang HiCache、Qwen3.8 hybrid state 以及现有 MTP 正确结合,那么未来 2080 Ti 多卡环境下的长上下文并发能力还有很大的想象空间。
写在最后
我一直觉得,老硬件真正被淘汰,往往并不是芯片彻底算不动了,而是主流软件开始不再愿意为它花时间。
RTX 2080 Ti 已经发布很多年。
但当四张 22GB 版本插在服务器里,看着 Qwen3.8-27B 跑到三位数 TPS,看着一轮请求连续生成四五万 tokens,最终完整走到结束标志,还是会觉得这批卡远没有到应该退休的时候。
Caovan SGLang SM75 Accelerator 做的事情,说到底也很简单:
既然新框架越来越偏向新 GPU,那就自己把 SM75 该补的那部分补回来。
如果你手里同样有 RTX 2080 Ti、Turing GPU,或者正在搭建自己的本地大模型服务器,希望在不大规模更换硬件的情况下继续把现有设备利用起来,这套方案也许值得你关注。
让旧卡继续干活,比让它们躺在机柜里吃灰更有意思。
产品名称:Caovan SGLang SM75 Accelerator
当前 GA 版本:v1.0.46
主要适配:RTX 2080 Ti / NVIDIA SM75 / Qwen3.8-27B / SGLang
核心能力:TP2 / TP4、多卡推理、MTP、AutoMTP、CUDA Graph、SM75 专用 deterministic kernel、超长输出保障、并发推理、多模态及商业化安装部署。
注:文中 TPS 数据来自特定硬件、模型和测试参数下的研发实测记录。实际性能会受到模型版本、量化格式、输入输出长度、并发数、MTP 接受率、GPU 拓扑、驱动版本等因素影响,请以实际运行环境为准。
原创文章,作者:朋远方,如若转载,请注明出处:https://caovan.com/caovan-sglang-sm75-accelerator-rtx-2080ti-qwen3-8/.html
 微信扫一扫