
如果手头还有 RTX 2080 Ti,可能已经有人劝你“别折腾了,换新卡吧”。这话不能说完全没道理:Turing 架构确实有年代感,尤其碰上新的推理算子、CUDA Graph 和多卡通信,很多现成方案并不打算专门照顾 SM75。
但我们一直觉得,硬件老,不代表没有继续榨出性能的价值。 这也是我们做 CAOVAN SGLang SM75 推理加速整合包的起点:不只是把 SGLang 装上去,而是围绕特定显卡、特定模型和真实使用场景,把启动、算子适配、推测解码、日志、授权与维护串成一套可操作的工具。
一、这套加速整合包,究竟“自研”在哪里?
SGLang 本身是开源的高性能推理框架,它已经提供了多 GPU 推理、批处理、缓存和 OpenAI 兼容接口等基础能力。CAOVAN 做的是在这个基础上,针对 SM75 / RTX 2080 Ti 以及本项目所使用的 Qwen3.8-27B-AWQ-INT4,加入一套有特定目标的适配和整合。
不让老架构被默认配置拖后腿
针对 Turing / SM75 与 INT4 量化推理路径处理兼容和性能问题,维护相应的运行配置与优化算子路径,避免盲目套用新 GPU 的预设。
双卡、四卡拓扑联动
启动时识别 GPU 选择与拓扑,结合张量并行规划运行方式。使用带 NVLink 的双卡时,可以按拓扑选择配对 GPU;实际通信效果以设备和日志为准。
把推测解码做成可配置策略
可关闭 MTP、手动选择 2~15 档,或设置 AutoMTP 候选集合。候选不是越大越好,显存、接受率和实际吞吐量都需要一起看。
安装、授权、日志和 API 一体化
自带交互式启动向导、环境检查、服务状态、TPS 日志,以及与网站授权体系衔接的安装流程。普通用户无需亲手拼装复杂的推理启动参数。
除此之外,程序把 CUDA Graph、模型原生推理路径、并发与上下文选择纳入统一管理,尽量让调优不依赖某一个测试题,也不绑定某一种客户端。Page Assist、One-API / New API 或直接调用 OpenAI 兼容接口,都应当由同一个后端服务承接。
二、测试平台:双卡 2080 Ti 22GB,模型 27B INT4
本轮记录来自我们自己的真机,而不是云服务器上截取的一张跑分图。核心硬件和软件环境如下:
这里特意强调“22GB”:普通 2080 Ti 的原生显存是 11GB,不能直接把这套测试环境等同于随手买来的两张标准卡。不同改显存方案、BIOS、驱动和散热条件,也会影响实际结果。
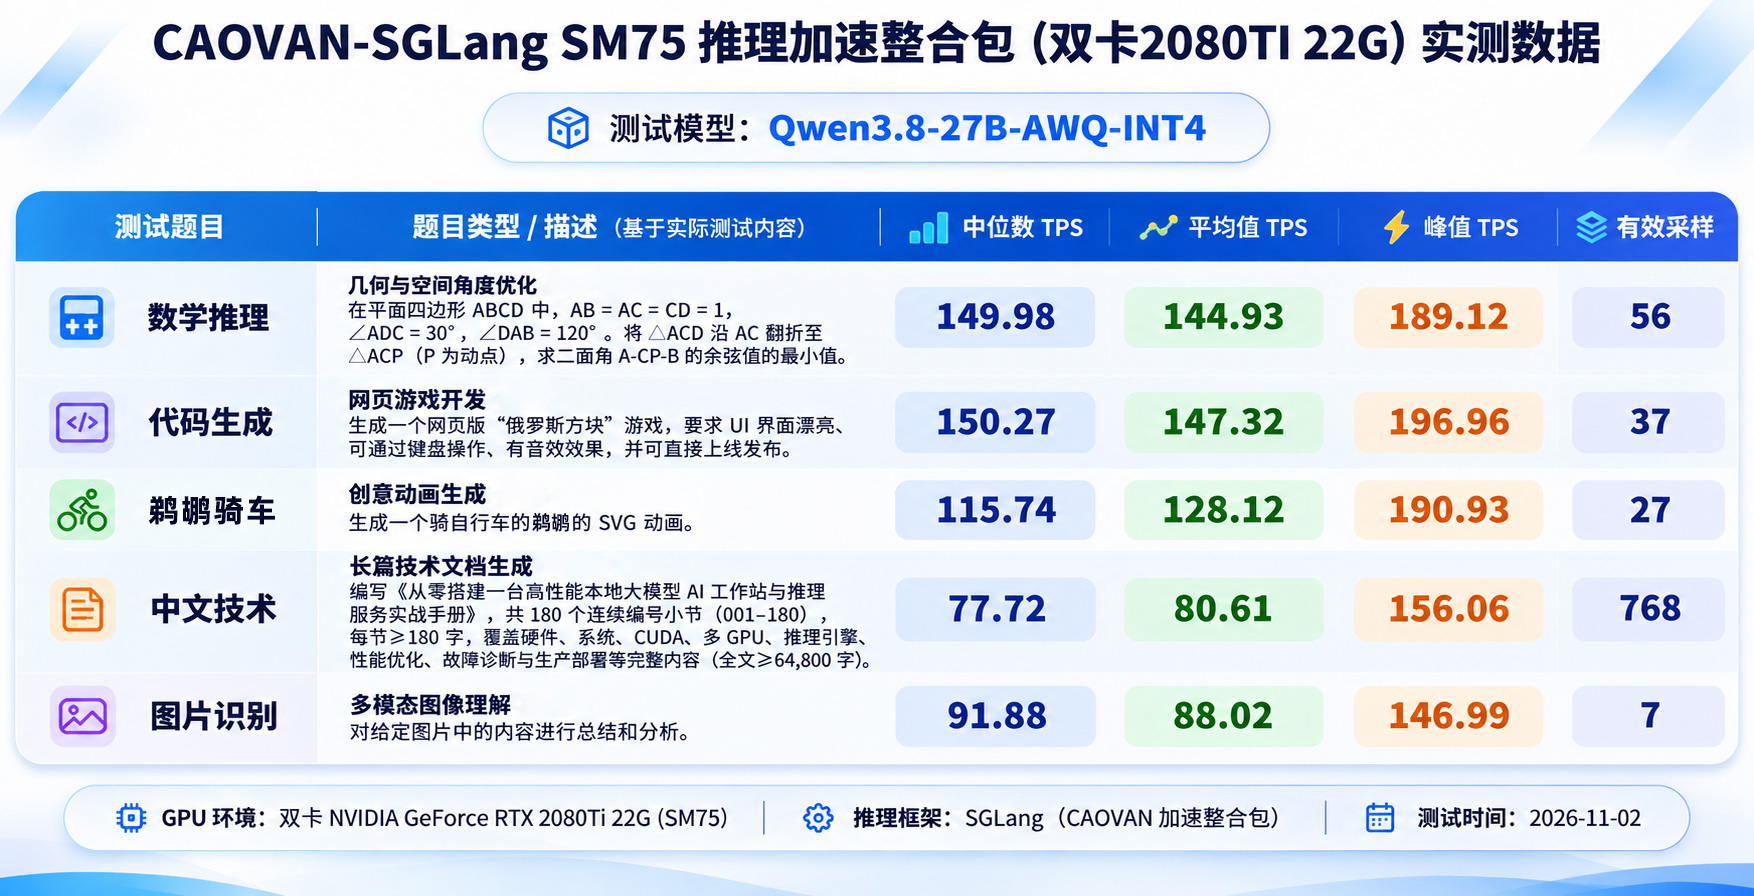
三、五道题真机实测:TPS 数据全部摆出来
我们没有只选一种容易跑高速度的短文本。五道题分别覆盖数学推理、网页代码生成、SVG 动画、超长中文技术写作和图片理解;任务差异很大,也更接近日常会遇到的使用场景。
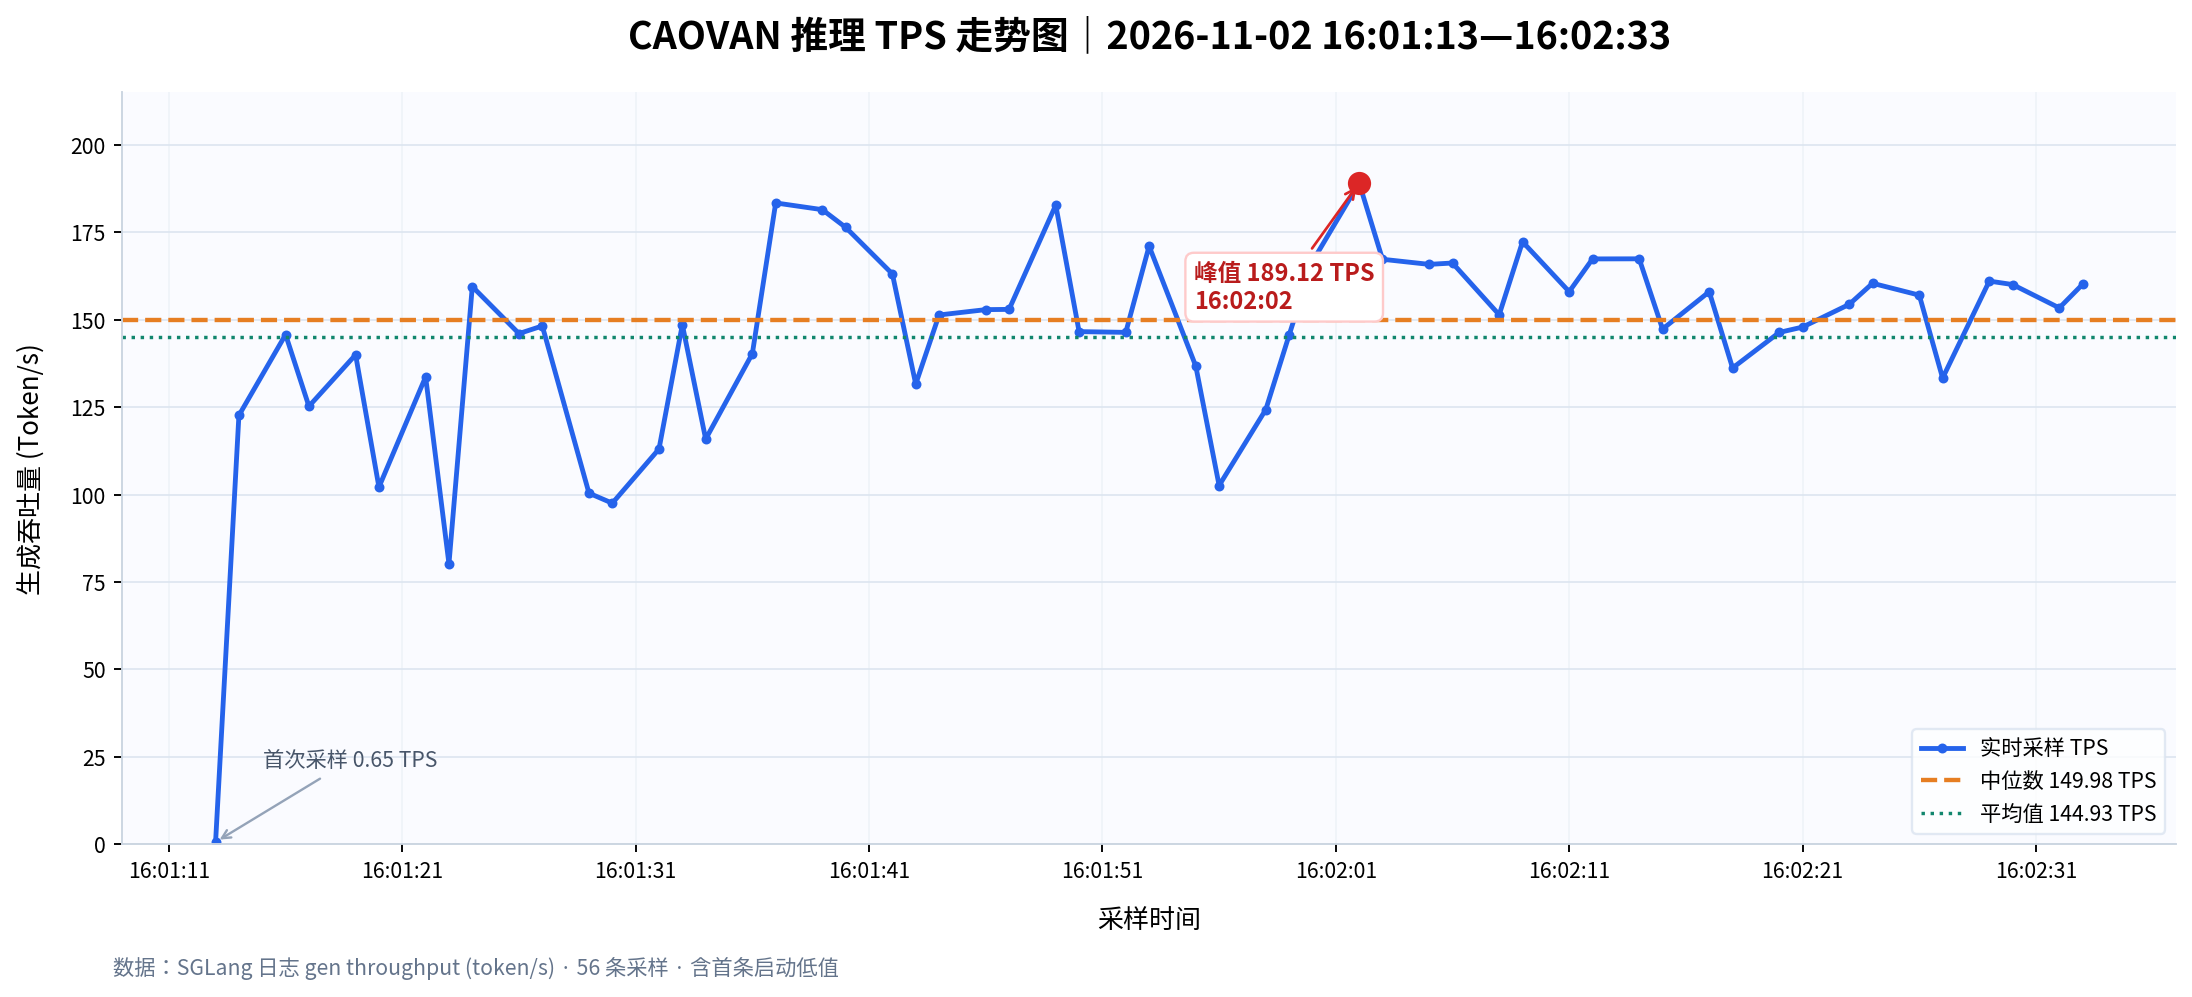
第一题:数学题
在平面四边形ABCD中,AB=AC=CD=1,\angle ADC=30^{\circ}, \angle DAB =120^{\circ}。将 \triangle ACD 沿 AC 翻折至 \triangle ACP,其中 P 为动点。求二面角 A-CP-B 的 余弦值的最小值。
测试表现:
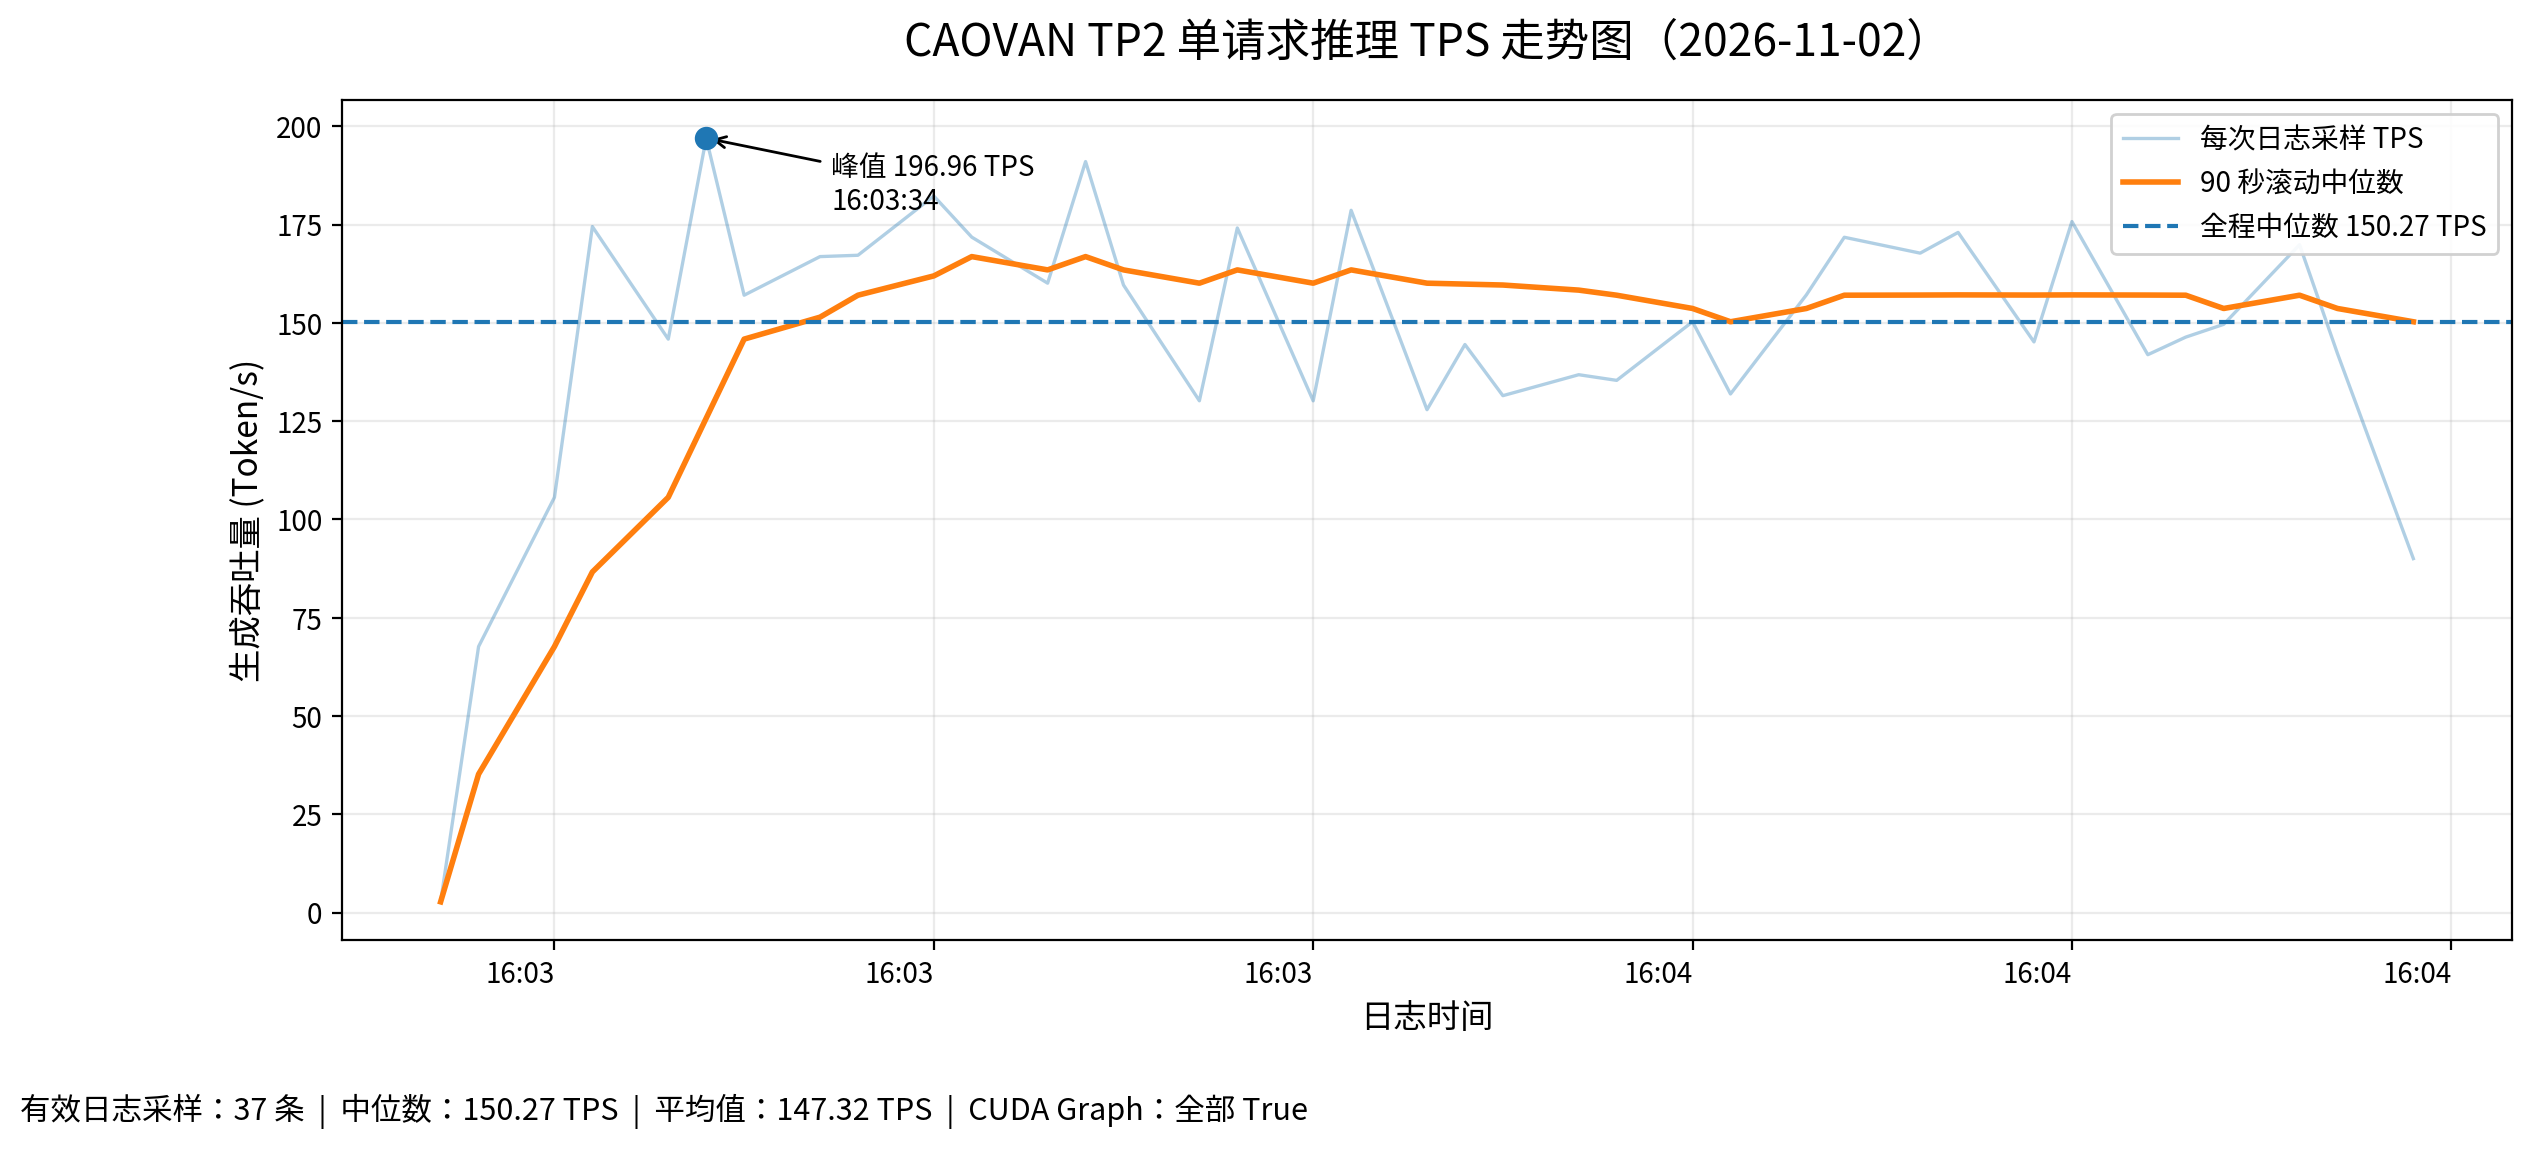
第二题:网页游戏-俄罗斯方块
生成一个网页版的“俄罗斯方块”的游戏,要求UI界面漂亮,可以实际通过键盘进行操作,有音效效果!可以直接上线发布!
测试表现:
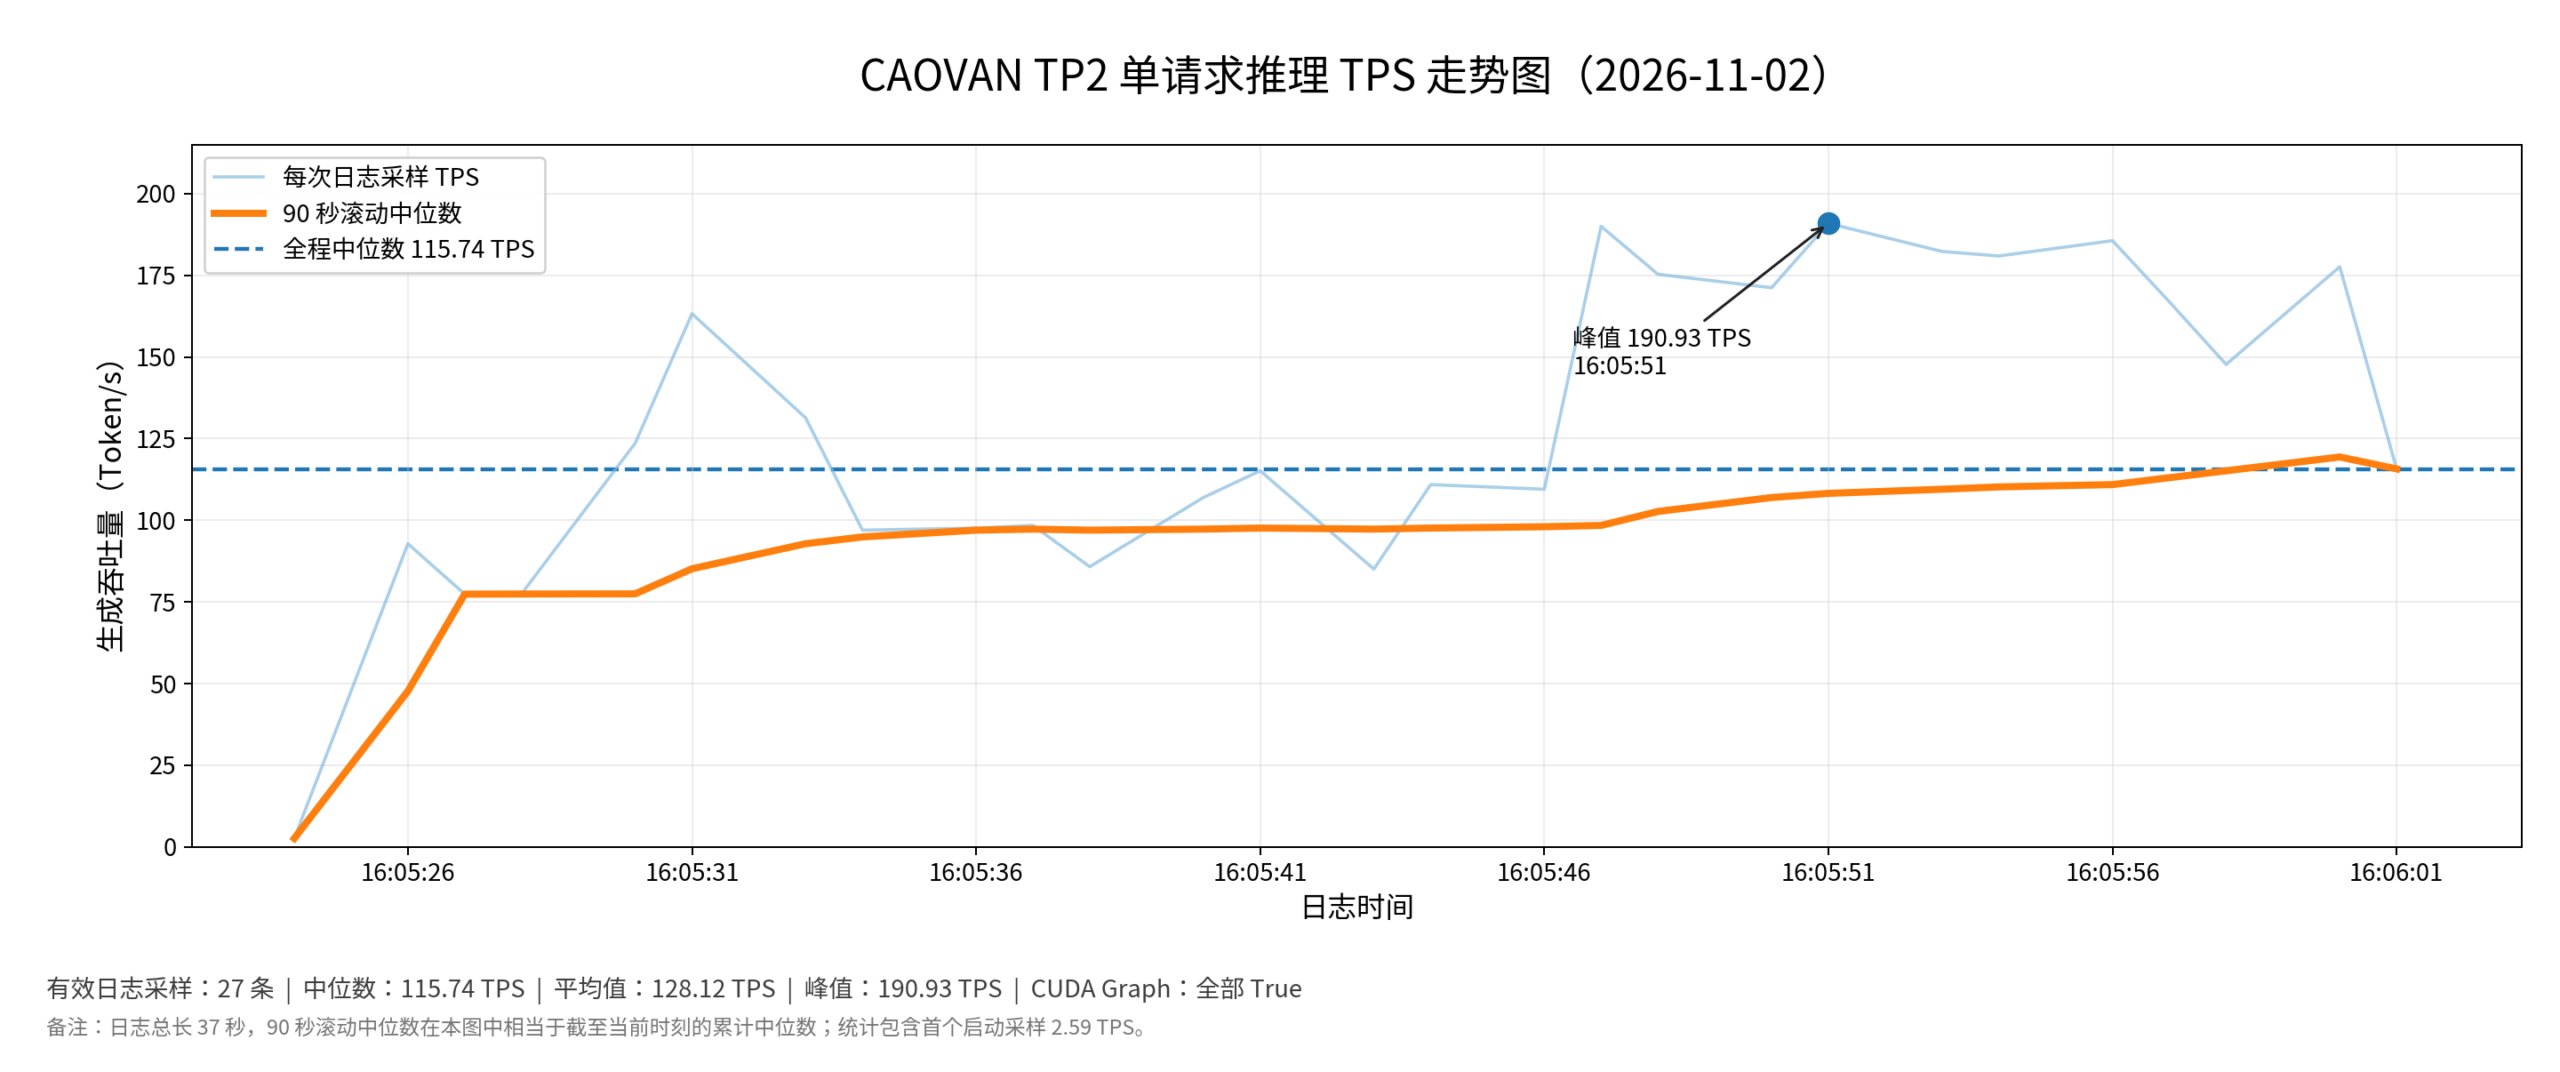
第三题:鹈鹕骑车
生成一个骑自行车的鹈鹕的 SVG 动画
测试表现:
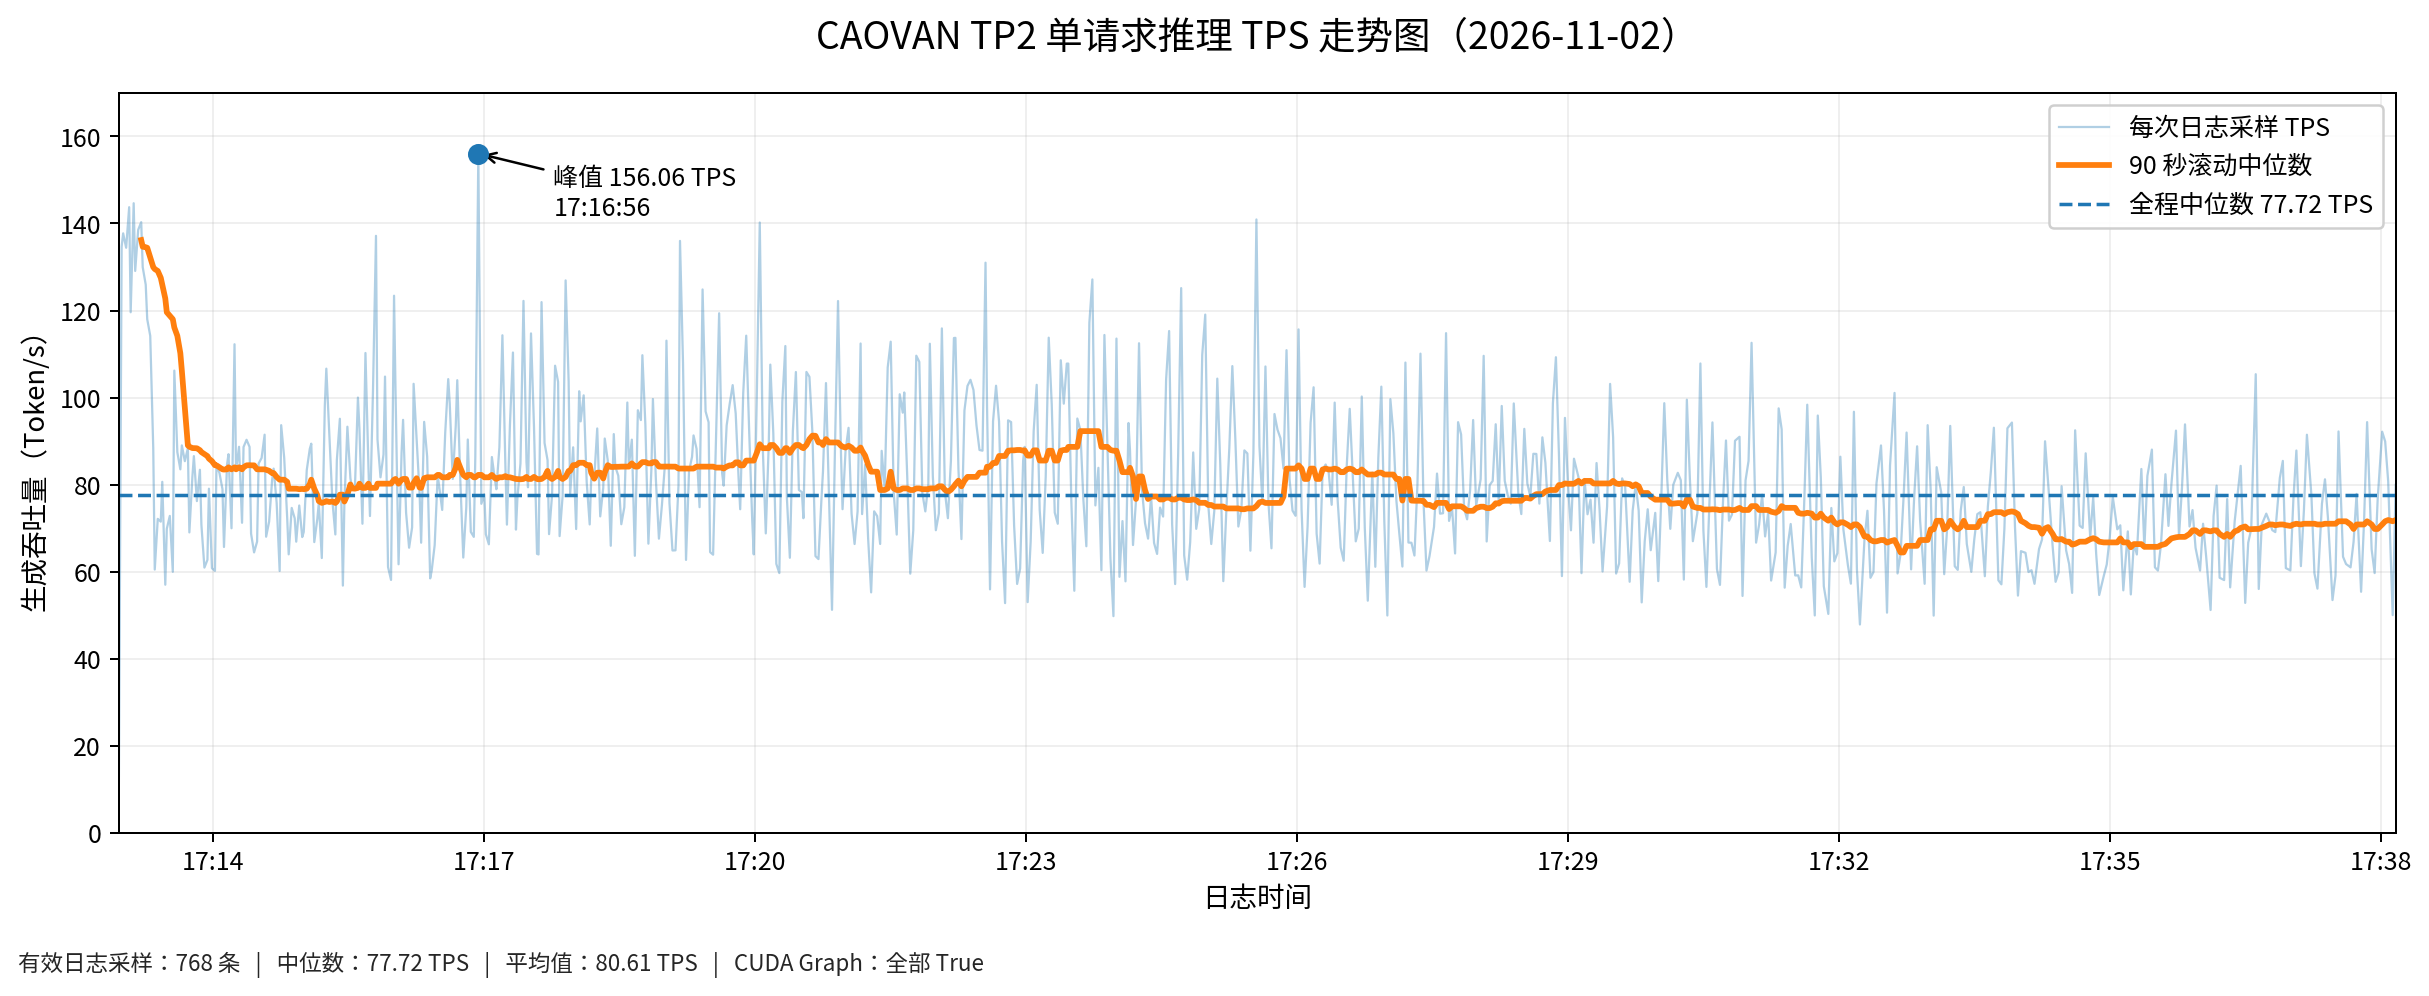
第四题:中文技术题
请完成下面这个任务,必须严格满足全部要求,不允许缩写、概括、省略或提前结束:
编写一份完整的《从零搭建一台高性能本地大模型 AI 工作站与推理服务实战手册》。
全文必须由 180 个连续编号的小节组成,编号严格从 001 到 180,不得缺号、跳号或合并小节。
每个小节必须包含:
一个明确的小节标题;
不少于 180 个中文字符的正文,不包括标题和编号;
至少包含一个具体的技术细节,例如命令、配置参数、硬件规格、故障现象、性能指标、部署方法、优化方法或实际案例;
不允许使用“同上”“略”“依此类推”“等等”来缩短内容;
每一个小节都必须完整写出,不能只列提纲。
180 个小节必须依次覆盖以下主题,并自然衔接:
PC 与服务器硬件选择、CPU、GPU、显存、内存、PCIe、NVLink、NUMA、主板、电源、散热、机箱、SSD、Linux 安装、Ubuntu 配置、NVIDIA 驱动、CUDA、Python、虚拟环境、PyTorch、模型下载、Hugging Face、ModelScope、量化模型、FP16、BF16、FP8、INT8、INT4、AWQ、GPTQ、KV Cache、Attention、FlashAttention、FlashInfer、Triton、CUDA Graph、Tensor Parallel、Pipeline Parallel、Data Parallel、NCCL、P2P、NVLink、多 GPU 拓扑、vLLM、SGLang、llama.cpp、OpenAI-Compatible API、长上下文、Prefix Cache、Radix Cache、Speculative Decoding、MTP、EAGLE、并发请求、吞吐量、TTFT、ITL、TPS、显存优化、CPU 内存优化、NUMA 调优、线程调优、网络服务、One-API/New API、反向代理、安全、日志、监控、benchmark、profiling、Nsight Systems、故障诊断、OOM、CUDA Error、NCCL Error、驱动冲突、性能突然下降、长序列性能、生产部署、开机启动、服务恢复、升级与回滚以及最终生产验收。
内容需要从初学者安装硬件开始,逐步深入到高级 CUDA、多 GPU 通信、推理引擎和性能分析,最后形成一套能够真正用于生产环境的完整方案。
特别要求:
001~030:硬件与系统基础;
031~060:CUDA、PyTorch 与模型基础;
061~090:量化、KV Cache 与 Attention;
091~120:vLLM / SGLang / 多 GPU 推理;
121~150:MTP、Speculative Decoding 与性能优化;
151~170:Nsight Systems、NCCL、CUDA 性能诊断与真实故障案例;
171~180:生产部署、稳定性测试和最终验收。
在涉及 Linux 操作时必须给出可执行的命令示例;涉及性能优化时必须说明“修改前现象 → 修改内容 → 修改后结果”;涉及故障时必须按照“症状 → 排查 → 根因 → 修复 → 验证”的结构说明。
最重要的硬性限制:全文不得少于 64,800 个中文字符。
必须持续生成直到完成第 180 节。即使答案已经很长,也不得自行总结、提前收尾或停止。第 180 节最后一行必须单独输出:
===== LONG OUTPUT TEST COMPLETE 180/180 =====
测试表现:
第五题:多模态题
请对图片中的内容进行总结和分析
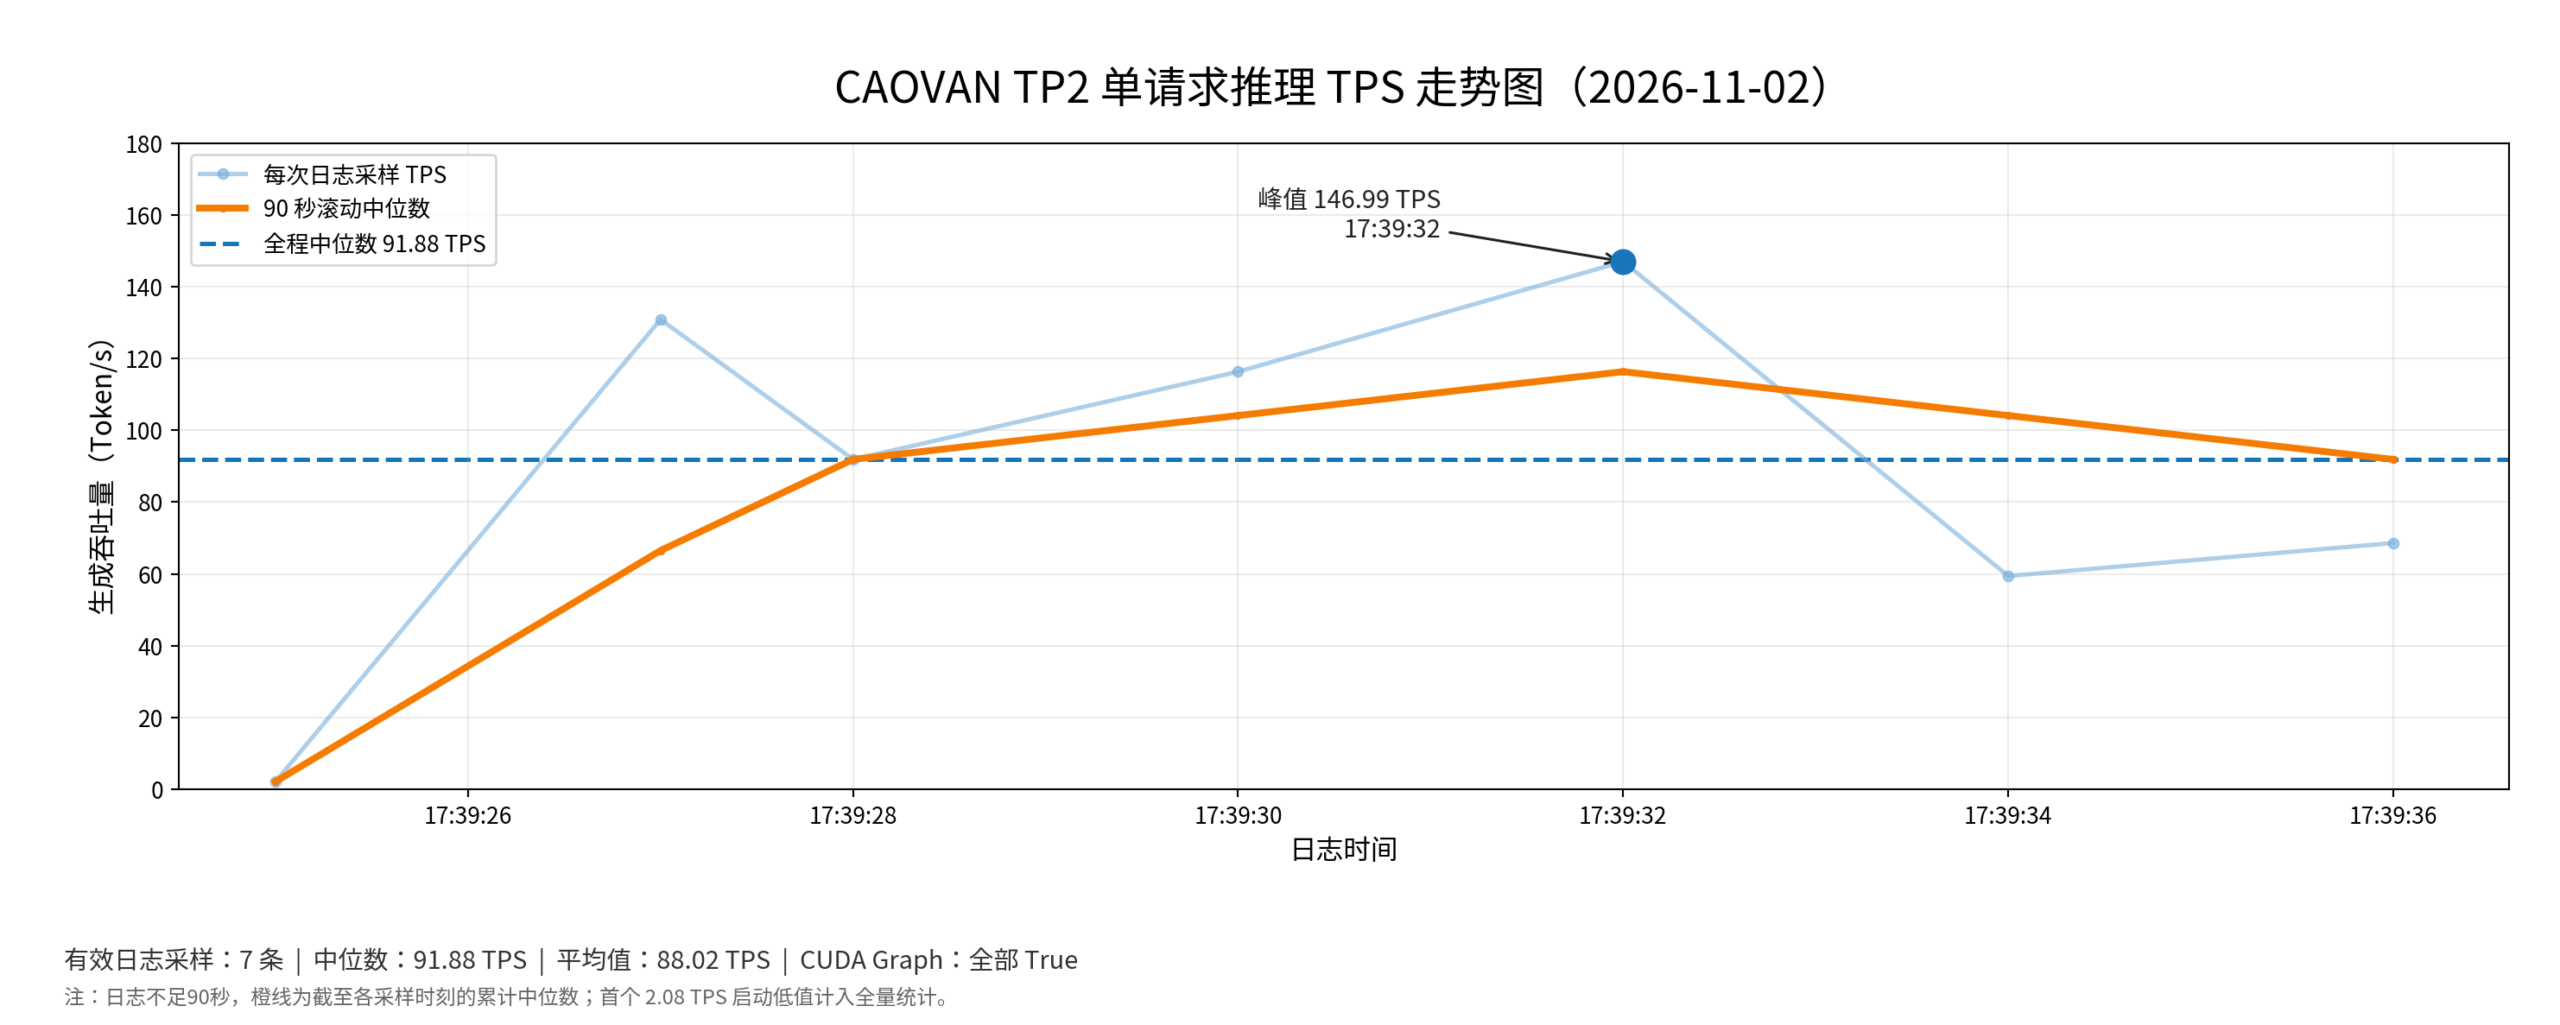
测试表现:
| 测试任务 | 中位数 TPS | 平均值 TPS | 峰值 TPS | 采样数 |
|---|---|---|---|---|
| 数学推理 空间几何二面角最值 |
149.98 | 144.93 | 189.12 | 56 |
| 代码生成 可键盘操作的俄罗斯方块网页 |
150.27 | 147.32 | 196.96 | 37 |
| 鹈鹕骑车 骑自行车的鹈鹕 SVG 动画 |
115.74 | 128.12 | 190.93 | 27 |
| 中文技术 180 节 AI 工作站实战手册 |
77.72 | 80.61 | 156.06 | 768 |
| 图片识别 对输入图片进行总结与分析 |
91.88 | 88.02 | 146.99 | 7 |
统计口径:从每道题日志的 gen throughput (token/s) 逐条提取;中位数为样本中位数,平均值为采样算术平均,峰值为最高单次采样。含启动阶段的低吞吐采样。以上不是请求端到端平均 TPS,也不是与原版 SGLang 的同条件加速倍数。
四、怎么安装?从检查环境到启动服务
第 1 步:确认硬件与系统
本文对应的已定义兼容环境是 Ubuntu 22.04、Python 3.10.12、SM75 GPU,以及与其匹配的驱动与运行依赖。驱动实测参考版本为 580.178.04。不要直接理解为任何 Linux、任何 CUDA 组合都能安装成功。
打开 Ubuntu 终端,先执行下面几条只读检查命令:
cat /etc/os-release
nvidia-smi
nvidia-smi topo -m
/usr/bin/python3 --version
df -h "$HOME"
主要确认:GPU 数量和显存是否正常、驱动是否已经工作、系统是否为预期版本、磁盘是否有足够空间。安装程序本身还会核对精确的 Python 3.10.12 版本、发行包校验值和运行依赖。全新安装需要预留至少约 12GiB 的额外可用空间;如果保留旧运行环境用于回滚,所需空间可能更多。模型权重占用要另外算。
第 2 步:准备本地量化模型
这套整合包不是“下载完 3MB 就自带 27B 模型”。安装包负责管理程序和依赖,模型权重需要单独准备。本文测试使用的是 Qwen3.8-27B-AWQ-INT4,请先从具有合法获取权限的模型来源下载对应文件,并保存在本机的一个完整目录里。
例如我们的测试机把模型放在 /data/qwen。你可以使用其他路径,但目录里必须包含模型配置和权重文件,不能只是空文件夹。注意 AWQ 的具体封装格式和模型版本要与当前 Profile 匹配,不能仅凭“INT4”三个字就认定所有量化包可互换。
第 3 步:从草凡博客获取专属安装命令
- 访问 草凡博客,登录拥有对应产品权限的账户。
- 进入 CAOVAN SGLang SM75 推理加速整合包的产品页面,按页面提示获取专属安装命令。
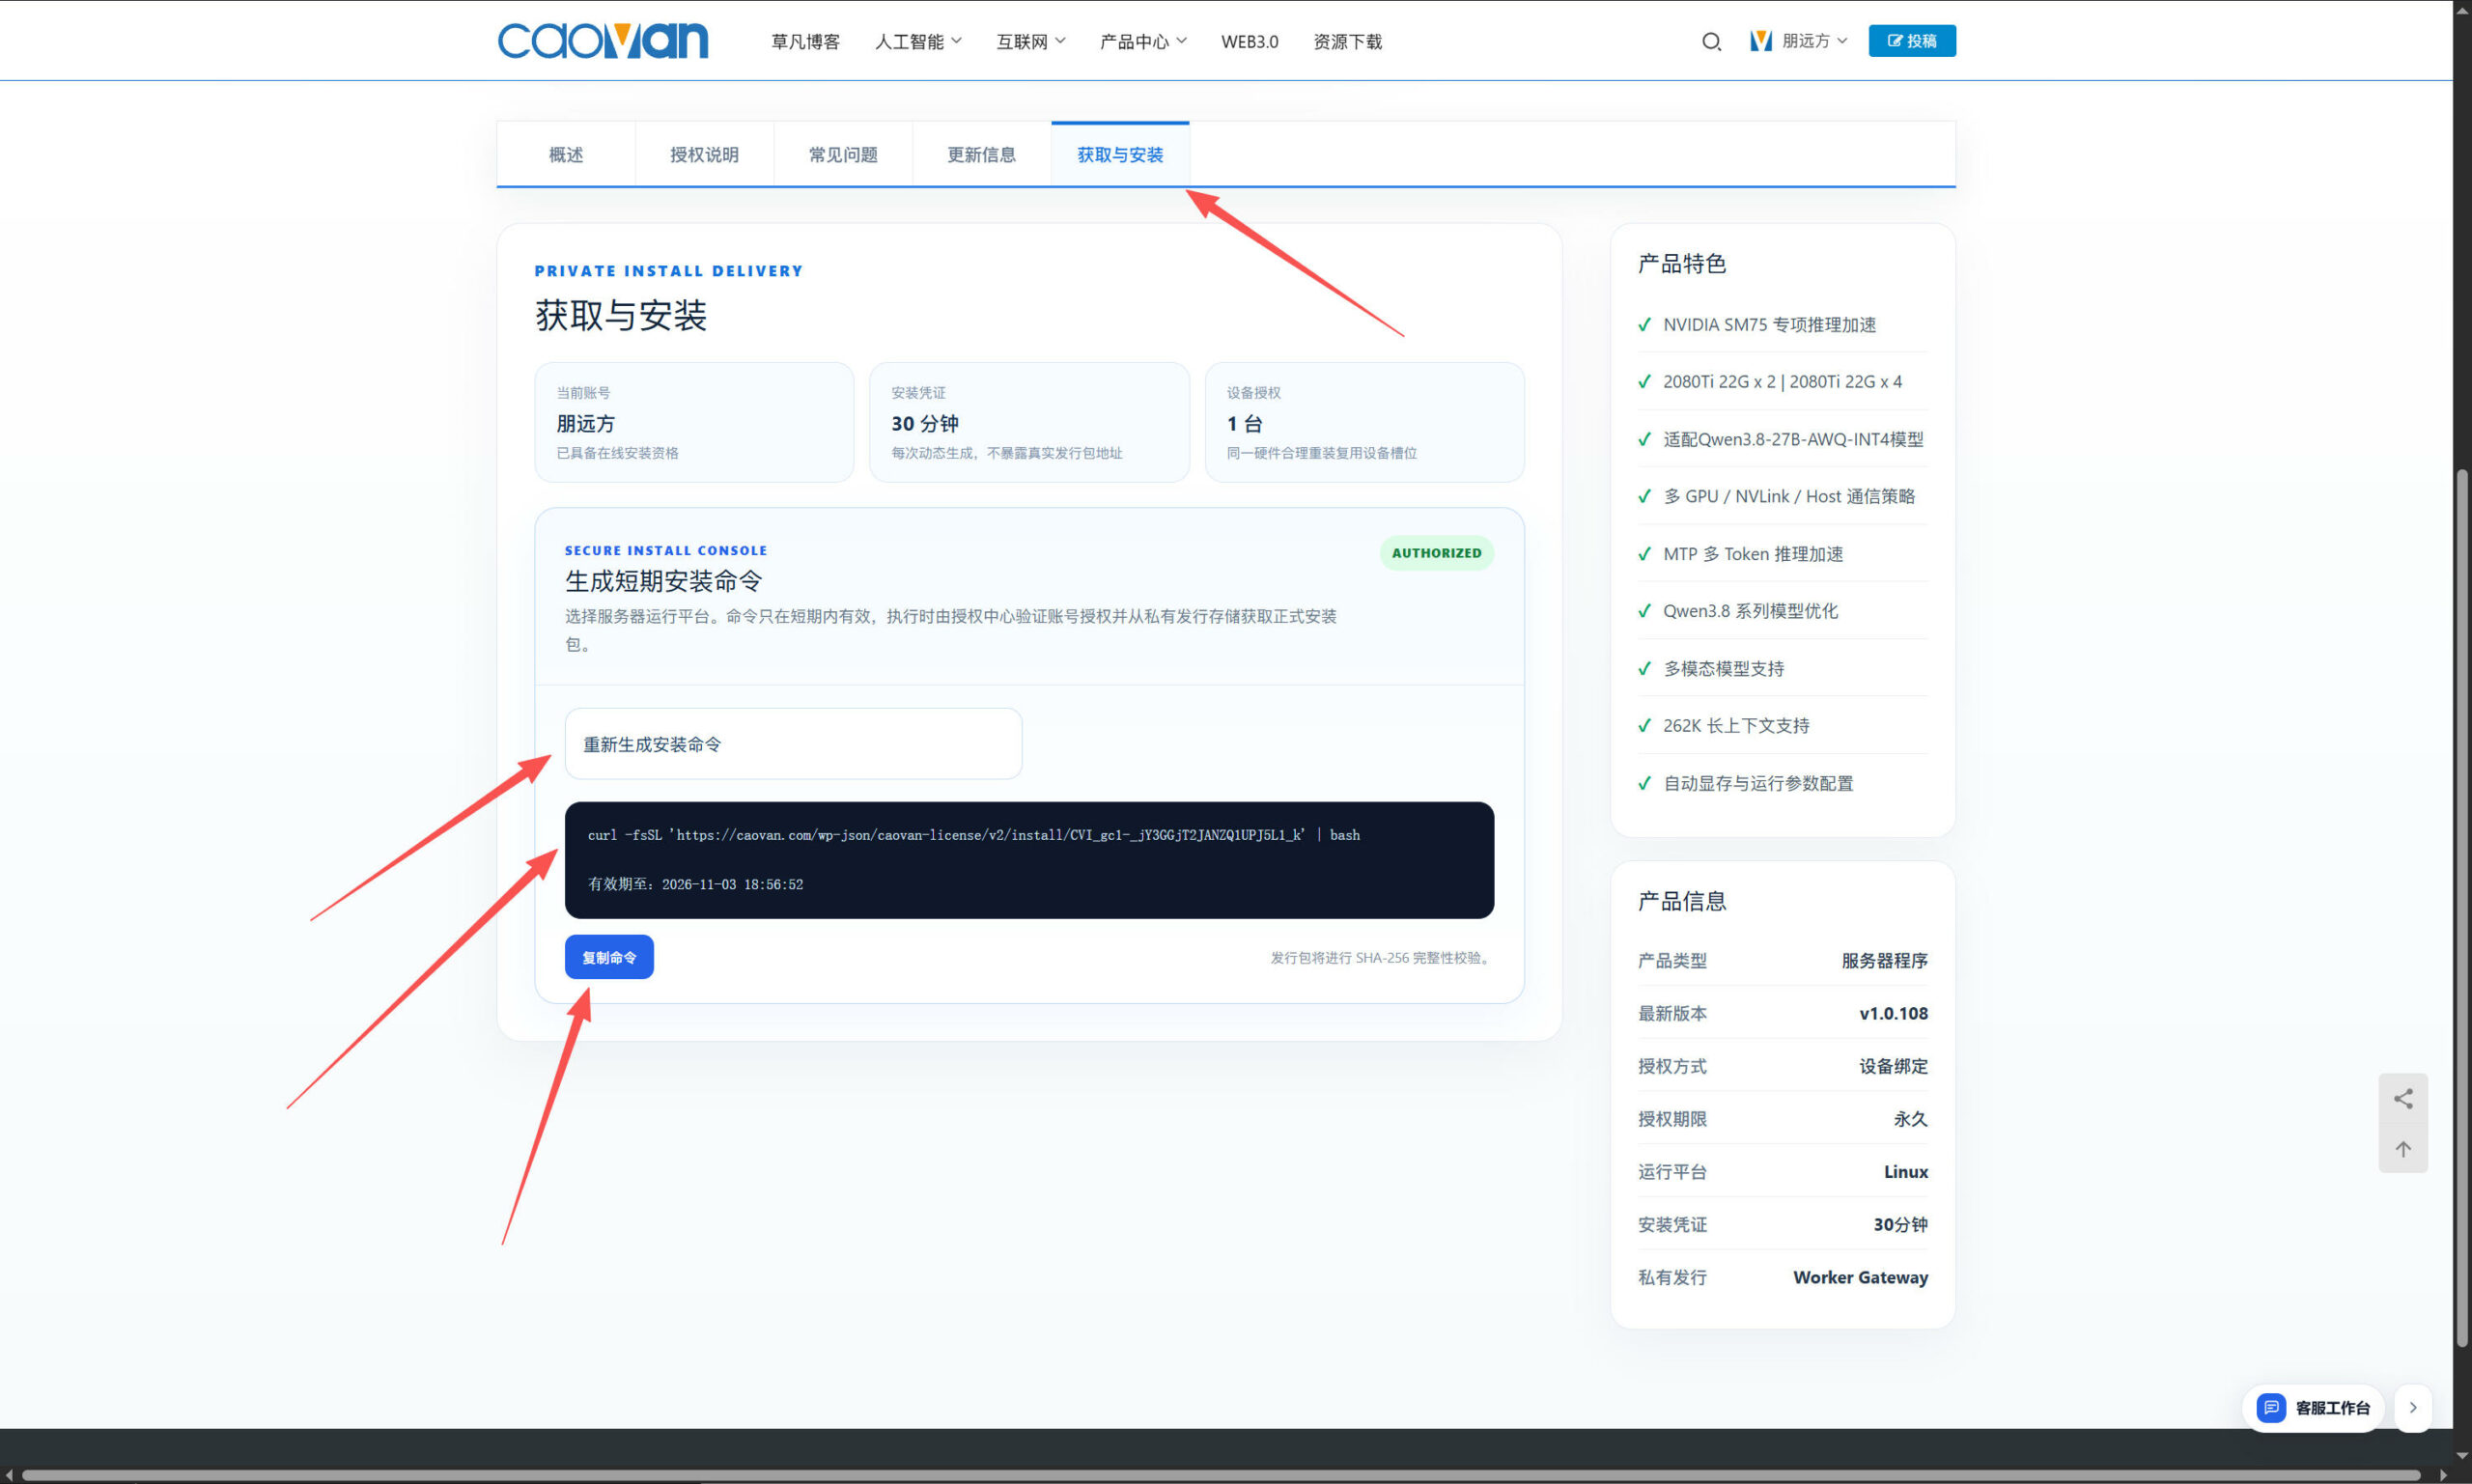
- 在准备好的 Ubuntu 主机上,复制并执行该命令;
- 等待安装器完成校验、依赖准备、环境检查及版本切换。安装完成后,服务不会自动启动,需要自己执行下一步。
第 4 步:运行环境检查,启动交互向导
安装成功后,建议先运行:
caovan-sglang doctor --model /data/qwen --gpus 0,1
caovan-sglang license
caovan-sglang start
上面 /data/qwen 是我们机器的示例路径。如果你的模型放在其他位置,请把它替换为实际路径。第一条是检查,第二条查看授权,第三条打开启动配置向导。
在向导里依次选择模型目录、GPU、TP/MTP 策略、并发、上下文长度、Temperature、思考等级、监听地址和运行方式。双卡用户优先选一组实际可用的 GPU;如果有 NVLink,先通过 nvidia-smi topo -m 核实卡间拓扑,再做选择。
第 5 步:MTP、并发和上下文怎么选?
第一次启动别急着所有开关拉满。想快速排查兼容问题,可以先选单并发 + 64K 上下文 + 固定 MTP,确认模型能正常响应后,再对比其他档位;对 AutoMTP 的不同候选集合也应逐一观察实际速度和显存占用。菜单提供固定 MTP2~MTP15、关闭和 Auto,但提供选项不等于每一档都已完成完整 GPU 质量验收。
根据程序当前的交互规则,并发数量会限制可选上下文上限:
| 最大并发数 | 菜单可选上下文长度(Token) |
|---|---|
| 1~4 | 32,768 / 65,536 / 131,072 / 262,144 |
| 5~8 | 32,768 / 65,536 / 131,072 |
| 9~16 | 32,768 / 65,536 |
这是当前菜单中的配置范围,并不意味着最大并发下每一路都能同时跑满所选上下文,更不代表长上下文速度保证。实际能力取决于显存、KV 状态、MTP 策略和请求内容。
思考等级方面,正常业务可先从 Medium 试起;数学题可以再比较 Low 和 XHigh。对于这种带原生思考机制的模型,不建议为了追求速度就假定“关闭思考”一定兼容。监听地址如果仅供本机使用,选 127.0.0.1 更省心;如需局域网客户端访问,可在受信任网络中按需选择 0.0.0.0。
第 6 步:查看服务状态、TPS 日志和 API 地址
启动成功后,下面几条命令最常用:
caovan-sglang status
caovan-sglang info
caovan-sglang logs --tps --tail 30
caovan-sglang logs -f
status 看服务是否存活;info 会显示 OpenAI 兼容接口和实际模型名称;logs --tps 查看最近速度记录;logs -f 持续跟踪日志(按 Ctrl+C 结束日志查看,不代表停止后台服务)。
如果使用默认端口 30001,可在服务器本机检查模型列表:
curl -fsS http://127.0.0.1:30001/v1/models
需要连接 Page Assist、One-API、New API 或其他支持 OpenAI 接口的客户端时,优先以 caovan-sglang info 输出的实际地址和 Model ID 为准。特别要注意:如果 One-API 跑在 Docker 容器里,容器内的 127.0.0.1 指向的是容器自己,不是宿主机;应该使用容器能够访问的宿主机地址,并做好访问控制。
第 7 步:停止服务与常见报错
caovan-sglang stop
caovan-sglang license --refresh
第一条停止受管理的模型服务;第二条尝试主动刷新授权。若遇到 LEASE_EXPIRED 或 LICENSE_GATE=BLOCKED,先检查网络、系统时间与网站授权状态,再回草凡博客按产品页面提示处理,不要通过改程序文件绕过授权。
如果出现启动失败、显存不足、GPU 通信异常,先保存原始日志,再降低 MTP 档位、并发或上下文进行对照。不要为了让数字好看而把失败请求从记录中悄悄删掉。 程序正常安装时会在 ~/caovan-sglang-runtime/logs 留存相关日志(自定义运行目录时位置也会变化)。
五、结语:2080 Ti 还没到只能吃灰的年纪
CAOVAN-SGLang SM75 推理加速整合包的方向很明确:把老 GPU 的潜力尽可能利用好,同时尽量把复杂的推理部署变成普通用户也能操作的流程。程序会继续更新,真实测试记录也会继续公开。大家更关心哪方面——MTP、长上下文、TP2 与 TP4 差异,还是多模态推理——也欢迎在评论区交流。
了解产品与获取安装资格:访问 草凡博客官网,在对应产品页查看当前可用发行版、授权资格和安装说明。不同版本和显卡配置的实际表现,请以各自发布说明及实测日志为准。
资料口径:实测 TPS 来自 2026-11-02 五组日志采样汇总;安装与功能描述根据 CAOVAN-SGLang SM75 Accelerator v1.0.108 发行包中的实际脚本、CLI 与兼容文档核对;SGLang 上游能力参见其官方开源仓库。本文不构成对所有 GPU、模型或并发配置的性能保证。
原创文章,作者:朋远方,如若转载,请注明出处:https://caovan.com/caovan-sglang-sm75-accelerator-rtx-2080ti-qwen3-8/.html
 微信扫一扫